ConcurrentHashMap 源码分析
作为HashMap的线程安全的版本,ConcurrentHashMap的使用频率是非常高的,本文将通过其源码来分析它的存储结构和实现原理。
JDK1.7 中的ConcurrentHashMap
存储结构
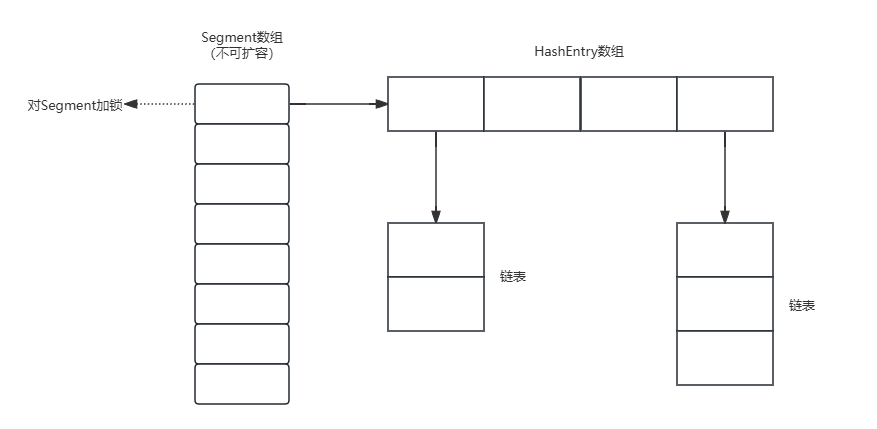
JDK7 ConcurrentHashMap存储结构
JDK7中ConcurrentHashMap的存储结构如上图,ConcurrnetHashMap由很多个 Segment 组合,而每一个 Segment 是一个类似于 HashMap 的结构,所以每一个 HashMap 的内部可以进行扩容。但是 Segment 的个数一旦初始化就不能改变,默认 Segment 的个数是16个,也可以认为 ConcurrentHashMap 默认支持最多16 个线程并发。
初始化
我们先从ConcurrentHashMap的无参构造方法来连接它的初始化流程。
1 | /** |
可以看出,无参构造函数是通过调用有三个参数的构造函数,并传入了三个默认值。再来看下有三个参数的构造函数
1 |
|
JDK7的ConcurrentHashMap的初始化过程总结如下:
- 必要参数校验
- 校验并发级别
concurrencyLevel的大小,如果大于预设的最大值,重置位该最大值。无参构造函数中默认为6. - 寻找并发级别
concurrencyLevel之上最近的2的幂次方值,作为初始化容量大小,默认是16。 - 记录
segmentShift偏移量,这个值为【容量 = 2 的 N 次方】中的 N,在后面 Put 时计算位置时会用到。默认是 32 - sshift = 28. - 记录
segmentMask,默认是 ssize - 1 = 16 -1 = 15. - 初始化
segments[0],默认大小为 2,负载因子 0.75,扩容阀值是 2*0.75=1.5,插入第二个值时才会进行扩容。
put方法
put方法的主要流程为:
- 计算要
put的key的位置,获取指定位置的Segment。 - 如果指定位置的
Segment为空,则初始化这个Segment.初始化
Segment流程:- 检查计算得到的位置的
Segment是否为null. - 为
null继续初始化,使用Segment[0]的容量和负载因子创建一个HashEntry数组。 - 再次检查计算得到的指定位置的
Segment是否为null.使用创建的 HashEntry 数组初始化这个Segment. - 自旋判断计算得到的指定位置的
Segment是否为null,使用 CAS 在这个位置赋值为Segment.
- 检查计算得到的位置的
Segment.put插入key,value值。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66/**
* Maps the specified key to the specified value in this table.
* Neither the key nor the value can be null.
*
* <p> The value can be retrieved by calling the <tt>get</tt> method
* with a key that is equal to the original key.
*
* @param key key with which the specified value is to be associated
* @param value value to be associated with the specified key
* @return the previous value associated with <tt>key</tt>, or
* <tt>null</tt> if there was no mapping for <tt>key</tt>
* @throws NullPointerException if the specified key or value is null
*/
public V put(K key, V value) {
Segment<K,V> s;
if (value == null)
throw new NullPointerException();
int hash = hash(key);
// hash 值无符号右移 28位(初始化时获得),然后与 segmentMask=15 做与运算
// 其实也就是把高4位与segmentMask(1111)做与运算
int j = (hash >>> segmentShift) & segmentMask;
if ((s = (Segment<K,V>)UNSAFE.getObject // nonvolatile; recheck
(segments, (j << SSHIFT) + SBASE)) == null) // in ensureSegment
// 如果查找到的 Segment 为空,初始化
s = ensureSegment(j);
return s.put(key, hash, value, false);
}
/**
* Returns the segment for the given index, creating it and
* recording in segment table (via CAS) if not already present.
*
* @param k the index
* @return the segment
*/
private Segment<K,V> ensureSegment(int k) {
final Segment<K,V>[] ss = this.segments;
long u = (k << SSHIFT) + SBASE; // raw offset
Segment<K,V> seg;
// 判断 u 位置的 Segment 是否为null
if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) {
Segment<K,V> proto = ss[0]; // use segment 0 as prototype
// 获取0号 segment 里的 HashEntry<K,V> 初始化长度
int cap = proto.table.length;
// 获取0号 segment 里的 hash 表里的扩容负载因子,所有的 segment 的 loadFactor 是相同的
float lf = proto.loadFactor;
// 计算扩容阀值
int threshold = (int)(cap * lf);
// 创建一个 cap 容量的 HashEntry 数组
HashEntry<K,V>[] tab = (HashEntry<K,V>[])new HashEntry[cap];
if ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u)) == null) { // recheck
// 再次检查 u 位置的 Segment 是否为null,因为这时可能有其他线程进行了操作
Segment<K,V> s = new Segment<K,V>(lf, threshold, tab);
// 自旋检查 u 位置的 Segment 是否为null
while ((seg = (Segment<K,V>)UNSAFE.getObjectVolatile(ss, u))
== null) {
// 使用CAS 赋值,只会成功一次
if (UNSAFE.compareAndSwapObject(ss, u, null, seg = s))
break;
}
}
}
return seg;
}
探究了获取Segment段和初始化Segment段的操作之后,我们来分析Segment的put方法。
1 | final V put(K key, int hash, V value, boolean onlyIfAbsent) { |
由于
Segment继承了 ReentrantLock,所以 Segment 内部可以很方便的获取锁,put 流程就用到了这个功能.
tryLock()获取锁,获取不到使用scanAndLockForPut方法继续获取。- 计算
put的数据要放入的index位置,然后获取这个位置上的HashEntry。 遍历
put新元素,为什么要遍历?因为这里获取的HashEntry可能是一个空元素,也可能是链表已存在,所以要区别对待。如果这个位置上的 HashEntry 不存在:
- 如果当前容量大于扩容阀值,小于最大容量,进行扩容。
直接头插法插入。
如果这个位置上的 HashEntry 存在:
- 判断链表当前元素 key 和 hash 值是否和要 put 的 key 和 hash 值一致。一致则替换值
- 不一致,获取链表下一个节点,直到发现相同进行值替换,或者链表表里完毕没有相同的。
- 如果当前容量大于扩容阀值,小于最大容量,进行扩容。
- 直接链表头插法插入。
- 如果要插入的位置之前已经存在,替换后返回旧值,否则返回
null.
这里面的第一步中的 scanAndLockForPut 操作这里没有介绍,这个方法做的操作就是不断的自旋 tryLock() 获取锁。当自旋次数大于指定次数时,使用 lock() 阻塞获取锁。在自旋时顺表获取下 hash 位置的 HashEntry。
1 | private HashEntry<K,V> scanAndLockForPut(K key, int hash, V value) { |
扩容rehash
ConcurrentHashMap的扩容只会扩容到原来的两倍。老数组里的数据移动到新的数组时,位置要么不变,要么变为index+oldSize,参数里的node会在扩容之后使用链表头插法插入到指定位置。
1 |
|
最后解释一下最后两个for循环:这里第一个 for 是为了寻找这样一个节点,这个节点后面的所有 next 节点的新位置都是相同的。然后把这个作为一个链表赋值到新位置。第二个 for 循环是为了把剩余的元素通过头插法插入到指定位置链表。这样实现的原因可能是基于概率统计.
get方法
get方法很简单,只需要两步:
- 计算得到key的存放位置。
- 遍历指定位置查找相同key的value值。
1 | public V get(Object key) { |
JDK1.8 的ConcurrentHashMap
存储结构
JDK1.8中的ConcurrentHashMap的存储结构相对于JDK1.7有了非常大的变化,JDK1.7是Segment数组+HashEntry数组+链表,而JDK1.8采用的是Node数组+链表/红黑树的方式。当冲突链表达到一定长度(8)时,链表会转换成红黑树。
ConcurrentHashMap 源码分析
https://huangpei1993.github.io/java-ji-chu/concurrenthashmap-yuan-ma-fen-xi/